
KTO(Stanford / Contextual AI):用前景理论把对齐做成「单条二元反馈」的效用最大化
📄 KTO: Model Alignment as Prospect Theoretic Optimization
2024-02 · Stanford University · Contextual AI(ICML 2024)· 代码
一句话:把「成对偏好」这个硬约束拆掉——每条样本只要一个「好/坏」二元标签,借 Kahneman-Tversky 前景理论的「损失厌恶」价值函数直接最大化生成的人类效用,而不是最大化偏好似然。它把 DPO 一类成功损失抽象成一族「人感知损失」(HALO),KTO 是其中显式编码前景理论偏置的一个实例。
📖 论文原文 Abstract(英文)
Kahneman & Tversky's prospect theory tells us that humans perceive random variables in a biased but well-defined manner (1992); for example, humans are famously loss-averse. We show that objectives for aligning LLMs with human feedback implicitly incorporate many of these biases—the success of these objectives (e.g., DPO) over cross-entropy minimization can partly be ascribed to them belonging to a family of loss functions that we call human-aware losses (HALOs). However, the utility functions these methods attribute to humans still differ from those in the prospect theory literature. Using a Kahneman-Tversky model of human utility, we propose a HALO that directly maximizes the utility of generations instead of maximizing the log-likelihood of preferences, as current methods do. We call this approach KTO, and it matches or exceeds the performance of preference-based methods at scales from 1B to 30B, despite only learning from a binary signal of whether an output is desirable. More broadly, our work suggests that there is no one HALO that is universally superior; the best loss depends on the inductive biases most appropriate for a given setting, an oft-overlooked consideration.
相关:DPO · Reward Model · SFT
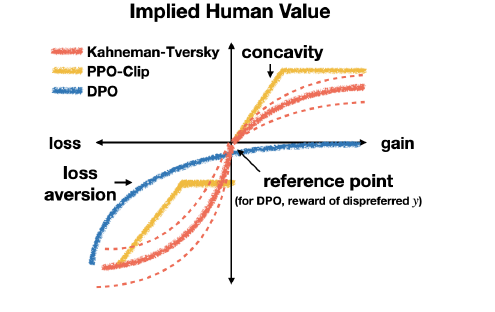
图源:Ethayarajh et al., KTO: Model Alignment as Prospect Theoretic Optimization(arXiv:2402.01306)Figure 1——三种 HALO 隐含的人类效用函数都共享损失厌恶、围绕一个参考点度量增益/损失(用于学习注解,版权归原作者)。
动机与创新点:偏好似然 ≠ 人类效用,二元反馈更便宜也更鲁棒
DPO 要求成对偏好数据:同一 prompt 下两个回答
第二个动机来自行为经济学。作者用前景理论(prospect theory)重新审视对齐:它解释了"人为何会做出不最大化期望值的决策"——相对某个参考点,人对损失比对等量增益更敏感(loss aversion)。论文进一步论证:包括 DPO、PPO-Clip 在内的一批成功对齐损失,之所以比朴素交叉熵好,部分原因正是它们隐式编码了这类人类感知偏置。作者把这类损失抽象成一个统一的函数族——HALO(human-aware loss),并证明 DPO、PPO-Clip 都是 HALO(Theorem 3.5)。KTO 则用 Kahneman-Tversky 的价值函数显式写出损失厌恶,直接最大化生成的效用而非偏好似然。
更宏观的论点是:"there is no one HALO that is universally superior"——最好的损失取决于具体场景该用什么归纳偏置,这是常被忽视的设计自由度。
关键创新:
- HALO 框架:把"人感知损失"形式化为一个函数族(带参考点的、凹于增益的、有损失厌恶的价值函数作用在隐式 reward 上),并证明 DPO / PPO-Clip 都落在其中,为"为什么这些损失好用"给了一个统一解释。
- KTO 损失:用 Kahneman-Tversky 价值函数构造一个新 HALO,只需单条样本 + 二元标签,直接最大化效用;在 1B–30B 全程匹配或超过 DPO。
- 两个权重
显式控不均衡:好/坏样本天然不均衡(线上点踩往往远少于点赞)时,按数量反向加权即可,无需配对;可承受到 1:10 量级的极端不均衡。 - 可跳过成对、甚至跳过 SFT:足够规模下 KTO 单独(不先 SFT)就能匹配 SFT+DPO,且不像无 SFT 的 DPO 那样把回复越写越长、产生幻觉。
- 更好的最坏情况保证:理论上 KTO 会"忽略噪声且非传递(intransitive)的反馈",对真实世界普遍存在的噪声偏好更鲁棒(Prop 4.1 / Theorem 4.3)。
方法:把前景理论价值函数套到隐式 reward 上
HALO:把成功对齐损失抽象成「人感知损失」族
先给隐式 reward 一个通用定义——
其中
Theorem 3.5. DPO and PPO-Clip are human-aware losses.
DPO 之所以是 HALO,关键在它把"被拒答案
KTO 损失:前景理论价值函数的单样本形式
KTO 直接采用 Kahneman-Tversky 的价值函数(原文 eq 4,相对参考点
经验上
- 引入
控风险厌恶强度——" 越大,增益侧越风险厌恶、损失侧越风险偏好"。它和 DPO 里的 作用类似(控 偏离 的强度),只是这里显式写进价值函数。 - 把损失厌恶系数
拆成 ——分别对应 desirable / undesirable 两类输出的权重。
最终 KTO 损失(原文 eq 8):
其中
读法:好样本要让
举例:把同一 prompt 下用户点赞的回答标 desirable、点踩的标 undesirable,各自独立喂进损失。点赞样本只需把自己的
顶到平均基线 之上;点踩样本只需被压到 之下——全程不需要"这条比那条好"的成对标注。
为什么 KTO 学得动:KL 一鼓就停的自约束
论文给的直觉很关键:
if the model increases the reward of a desirable example in a blunt manner, then the KL penalty also rises and no progress is made.
也就是说,如果模型只是粗暴地抬高某个好样本的似然,参考点
理论上
三个要点:
- 用错位的
而非对应的 :因为 是被人刻意选为"典型好/坏"的输出、reward 量级不具代表性,错位的 更接近"随机输出"的基线。 - 截断到
:带来正偏差但方差更低——作者认为人感知的参考点本就有偏(不会用完整分布做平均,而是"可得性启发式"),所以有偏估计反而合理。 - 必须 detach(不回传梯度):
只作基准线、"do not backpropagate through ; it exists purely to control the loss saturation"。让它带梯度会破坏前景理论语义并使训练不稳。
一个实用捷径:若 KTO 紧接在用同一份数据做的 SFT 之后(SFT 模型即
举例:若 desirable : undesirable = 1 : 10,则设
。区间偏向"增益敏感"(gain sensitivity)——经验上"产出好输出比避免坏输出更重要";但在毒性防控这类最坏情况更要紧的任务,可反过来设 。
实现要点
# KTO loss:注意参考点 z0 在 batch 内共享、且 detach
def kto_loss(policy, ref, x, y, label, beta, lam_D, lam_U):
    # label: 1=desirable, 0=undesirable
    pi  = policy.seq_logprob(x, y)
    with torch.no_grad():
        rf = ref.seq_logprob(x, y)
    r_hat = pi - rf                                # 隐式 reward(log 比)

    # 参考点 z0: 用错位配对样本估计 KL, 截断到 >=0, 不回传梯度
    z0 = compute_kl_reference(policy, ref, x).clamp_min(0).detach()

    v_D = lam_D * torch.sigmoid(beta * (r_hat - z0))   # 好样本: 越超过 z0 越好
    v_U = lam_U * torch.sigmoid(beta * (z0 - r_hat))   # 坏样本: 越低于 z0 越好
    v = torch.where(label == 1, v_D, v_U)

    loss = (torch.where(label == 1, lam_D, lam_U) - v).mean()
return loss- 参考点
必须 detach 且截断到 ;它是"当前策略平均偏移多少"的基准估计,不是优化对象。 - batch 内样本不独立:
跨样本估计,KTO 有效性对 batch 内好/坏混合比例敏感——每个 batch 尽量同时含好样本和坏样本,否则参考点估偏。microbatch 至少为 2,论文建议 batch 8–128(实验用有效 batch 32)。 - 与 DPO 一样:logprob 对 response token 求和、mask 掉 prompt 与 padding;reference 可冻结或预计算缓存。
- 现成实现:HF TRL 的
KTOTrainer,数据集每行给prompt / completion / label(布尔),并暴露desirable_weight/undesirable_weight对应。
调参与实践经验
- 学习率要比 DPO 大很多:因 reference 调整后的 reward 量级更小,KTO 推荐默认 5e-6(AdamW),约为 DPO 5e-7 的 2×–10×。
控风险厌恶:大模型(已做过 SFT)用低 ;小模型直接 KTO(无 SFT)用高 。可先沿用 DPO 经验值再扫。 - 不均衡时调
是第一旋钮:按上面 区间反向设 ,目标让两类对梯度总贡献相当。 - 先 SFT 再 KTO 仍是默认更稳的路径(reference 是个能用的指令模型);但足够规模下可省 SFT 直接 KTO。
- 监控指标:分别看好/坏样本上的隐式 reward 均值是否朝预期方向分离;若坏样本 reward 不降,多半是
太小或 batch 内坏样本太少。
实验结果:1B–30B 匹配或超过 DPO,且抗极端不均衡
KTO ≥ DPO,全程 1B–30B
把 §3.3 的 winrate 评测(GPT-4-0613 当裁判,比对齐模型 vs SFT 目标输出)重跑到各家:
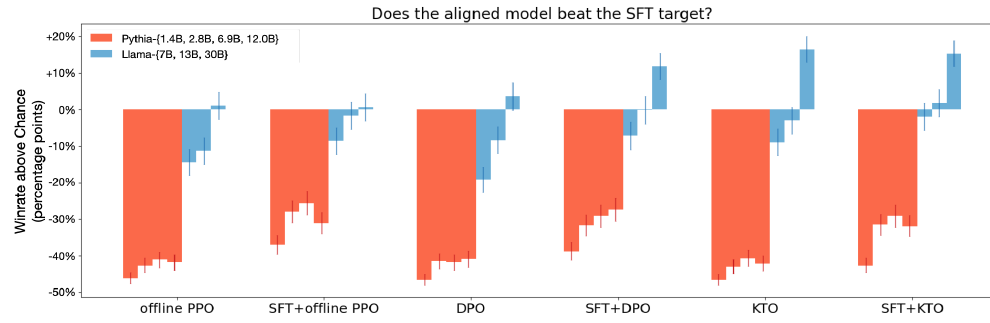
图源:Ethayarajh et al., KTO: Model Alignment as Prospect Theoretic Optimization(arXiv:2402.01306)Figure 3——KTO 在 1B–30B 全程不输 DPO;Llama 上 KTO 单独即追平 SFT+DPO、显著优于 DPO 单独(用于学习注解,版权归原作者)。
- SFT+KTO 在 1B–30B 全程与 SFT+DPO 持平,尽管只学二元弱信号。
- Llama-{7B,13B,30B} 上 KTO 单独 > DPO 单独,且在 7B、30B 显著(
,经多重比较校正)。Pythia 上两者无显著差异,作者推测"需要最小模型容量这些差异才显现"。 - 更早一组对照(Figure 2)显示 HALO(DPO、offline PPO)整体优于非 HALO(SLiC、CSFT),且只有 HALO 对齐的 Llama-{13B,30B} 能把 winrate 顶到 50% 以上——印证"是 HALO 这个归纳偏置在起作用"。
不靠成对、抗不均衡、甚至能省掉 SFT
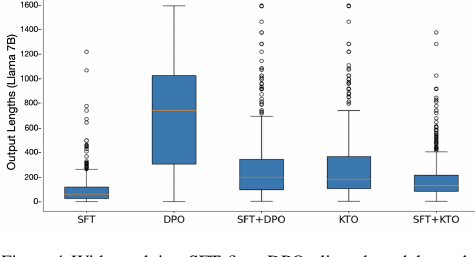
图源:Ethayarajh et al., KTO: Model Alignment as Prospect Theoretic Optimization(arXiv:2402.01306)Figure 4——不先做 SFT 时,DPO 对齐的模型倾向 ramble/hallucinate(输出超长),KTO 不受此困扰(用于学习注解,版权归原作者)。
- 可跳过 SFT:足够规模(Llama-13B/30B)下,KTO 单独就能匹配 SFT+KTO,是唯一表现出这一行为的方法——因为 KTO 把平均回复长度保持得差不多,而无 SFT 的 DPO 会让回复长度暴涨(上图)。
- KTO 数据不必来自偏好:随机丢弃 desirable 数据做不均衡测试,丢掉 90% 的 desirable 数据(desirable:undesirable 从 1:1 变 1:10)后,按
区间补偿(如 ),KTO 仍胜过 DPO(Figure 5)。 - 天然非成对数据:在 OpenAssistant 上对齐 Mistral-7B,每个
只用一个 (one- -per- )、彻底抹掉成对结构、训练数据少 72%,KTO 仍同时超过 DPO 与官方 Mistral-7B-Instruct(下表)。
| 方法(Mistral-7B / OpenAssistant) | Winrate vs SFT 目标 |
|---|---|
| Mistral-7B(未对齐) | 0.525 |
| Mistral-7B + DPO( | 0.600 |
| Mistral-7B + KTO(全部 | 0.652 |
| Mistral-7B + KTO(one- | 0.631 |
| Mistral-7B-Instruct(官方) | 0.621 |
生成基准与设计消融(Zephyr-β-SFT / UltraFeedback,1 epoch)
| 方法 | MMLU | GSM8K | HumanEval | BBH |
|---|---|---|---|---|
| SFT | 57.2 | 39.0 | 30.1 | 46.3 |
| DPO | 58.2 | 40.0 | 30.1 | 44.1 |
| ORPO( | 57.1 | 36.5 | 29.5 | 47.5 |
| KTO( | 58.6 | 53.5 | 30.9 | 52.6 |
| KTO(one- | 58.0 | 50.0 | 30.7 | 49.9 |
- GSM8K 提升最猛:在 UltraFeedback 上仅把 DPO 换成 KTO,数学推理 +13.5 分(40.0→53.5)。
- 每个设计都要紧(消融):去掉参考点
(不再是 HALO)→ BBH −3.6 / GSM8K −4.0;把价值函数改成处处凹的 (像 DPO)→ BBH −9.4 / GSM8K −11.0;改成风险中性的恒等函数 → BBH 直接崩盘。这从反面验证了"前景理论形状(带 、损失厌恶、非对称)"是 KTO 有效的根因。 - 推荐超参(Table 1,AdamW / 有效 batch 32 /
):Llama-3 8B 用 LR 5e-6、 取 0.05(SFT+KTO)或 0.10(KTO 直训);Qwen2.5-3B-Instruct 直训 KTO 时 可大到 0.50。
看榜须知:这些分数的口径、底座、SFT 数据、采样设置各异,跨设置直接比绝对值意义有限;当作"同数据量下 KTO 与 DPO/ORPO 同档可比、二元信号不吃亏"的量级参照即可。
在偏好对齐谱系里的位置
| 维度 | DPO | KTO |
|---|---|---|
| 数据形式 | 成对 | 单条 |
| 数据获取成本 | 高(需排序) | 低(点赞/点踩、单测通过即可) |
| 参考点 | 「被拒答案 | 「策略相对 ref 的平均 KL 偏移」(batch 内估、detach) |
| 是否需要 reference | 需要 | 需要(标准版);论文给了去 reference 的内存高效变体(略弱) |
| 损失结构 | 成对 sigmoid 排序 | 单样本前景理论价值函数 |
| 正负不均衡 | 需配对,天然平衡 | 用 |
| batch 内耦合 | 无(每对独立) | 有(参考点 |
| 噪声/非传递偏好 | 可能拟合到少数派偏好 | 理论上确定性产出多数派偏好,最坏情况更好 |
| 同数据量效果 | 强基线 | 1B–30B 匹配或超过 DPO |
- vs DPO:核心权衡是"用 batch 内共享参考点这点耦合,换不需要成对数据的巨大数据优势"。手上本来就是干净成对数据时,DPO 通常更直接;论文还从理论上指出——当偏好数据噪声小、非传递性低时 DPO 更优(KTO 有欠拟合复杂分布的风险,可用更低
+ 更多 epoch 缓解);但当数据天生二元、严重不均衡、或噪声大/自相矛盾(SHP、OpenAssistant、UltraFeedback 这类公开集都不同程度如此),KTO 才显出价值,也解释了它为何能匹配甚至超过 DPO。 - vs RLHF / Reward Model:HALO 框架把 RLHF 的 PPO-Clip 也纳入同一族(Theorem 3.5),说明"在线 RL + 显式 reward model"和"离线闭式损失"共享同一套人感知归纳偏置;KTO 站在离线一侧,省掉了单独训 reward model 与在线采样的开销。
- vs ORPO 等 reference-free 方法:KTO 也有"假设
为均匀分布"的去 reference 变体( 退化成 ),内存更省、在部分任务上仍胜 DPO,但整体不如标准 KTO,且对损失厌恶超参更敏感。 - 理论亮点:Prop 4.1 指出"当某样本的隐式 reward 趋于
(太难或太易学)时,KTO 对该样本的梯度趋于 0"——等于自动忽略噪声与离群反馈,这对充满噪声的真实反馈是「因祸得福」;Theorem 4.3 进一步证明在自相矛盾的偏好下,DPO 最优策略可能输出少数派偏好答案,而损失中性( )的 KTO 会确定性地输出多数派,最坏情况保证更好。这是"二元信号反而更鲁棒"的根因。