
LoRA+(UC Berkeley):给 B 矩阵更大学习率,修正宽网络下 LoRA 的次优动态
📄 LoRA+: Efficient Low Rank Adaptation of Large Models
2024-02 · UC Berkeley(Simons Institute / 统计系)· 代码
一句话:用无穷宽尺度分析证明「
📖 论文原文 Abstract(英文)
In this paper, we show that Low Rank Adaptation (LoRA) as originally introduced in (Hu et al., 2021) leads to suboptimal finetuning of models with large width (embedding dimension). This is due to the fact that adapter matrices
相关:LoRA 家族总览 · LoRA · rsLoRA · AdaLoRA · PiSSA · DoRA
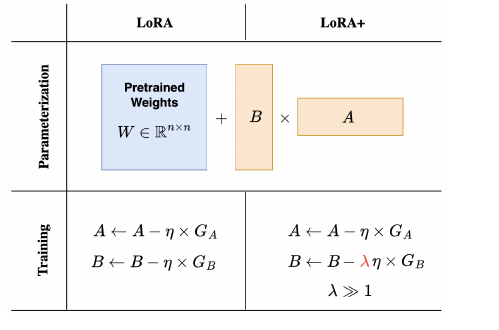
图源:Hayou, Ghosh & Yu, LoRA+: Efficient Low Rank Adaptation of Large Models(arXiv:2402.12354)Figure 1——LoRA 与 LoRA+ 的唯一区别在 B 的学习率(用于学习注解,版权归原作者)。
动机与创新点:宽网络下同学习率次优,靠 μP 式尺度分析重设 A/B 学习率
LoRA 把权重的微调增量写成低秩分解
并默认用同一个学习率同时更新
we are missing crucial hyperparameters in the standard LoRA setup.
动机来自
- 初始化不对称:要让微调从预训练点出发,乘积
初始须为 0,于是必有一个矩阵零初始化。论文用两种合法方案—— Init[1]:(即 零初始化, 随机,对应 Hu et al. 原版); Init[2]:。训练初期一个矩阵已携带信息、另一个还是零,二者状态完全不同。 - 梯度尺度不对称:前向是
。 的梯度依赖被激活过的 , 的梯度依赖 (初值很小)。在宽度 极限里,若两者共用一个学习率,必有一个矩阵的特征更新被"卡住",无法让每层输出都发生 量级的有效变化(即"高效特征学习")。
作者沿用近年神经网络无穷宽尺度分析(μP / 最大更新参数化的同一套方法论)研究 LoRA 微调动态的无穷宽极限,证明:要让
关键创新:
- 把"设 LoRA 学习率"上升为一个尺度理论问题:首次给出 LoRA 学习率的有原则指引——此前文献只有对 rank 的经验建议,"there is no principled guidance for setting LoRA learning rate"。
- 诊断标准 LoRA 的次优性(Proposition 1):同一学习率下,无论怎么取
,都无法让 、 的"线性特征更新"同时是 ,因此宽网络下 LoRA 微调"不高效"。 - 给出修正方案 LoRA+:把
、 放进两个参数组、设 ( 固定),只调一个基准 ,把二维调参降回一维。理论最优阶 。 - 零额外成本:不增参数、不改前向、不改初始化,唯一改动是优化器分组学习率,推理与 LoRA 完全一致、可正常合并回基座。
- 广泛实证:在 RoBERTa / GPT-2(GLUE)与 Llama-7b(flan-v2 / MNLI)上验证
一致更优,并给出按初始化方案选 的经验值。
方法:用 μP 式尺度分析推导 A/B 学习率比,落到一行优化器改动
玩具模型:把"高效学习"拆成三项更新
为讲清机制,论文先用一个线性玩具模型(
固定预训练权重
:固定 、只更新 带来的输出变化("线性"特征更新); :固定 、只更新 带来的输出变化(另一个"线性"更新); : 的乘性项,同时更新 时的复合更新。
理想的"高效学习"要求两个线性项都不被压垮——论文据此给出效率的定义:当
举例:若
,意味着更新 几乎不改变输出——模型实际只在训 ,等于浪费了一半适配自由度;反过来同理。高效就是要避免任何一边退化。
Proposition 1(标准 LoRA 的次优性):在 Init[1]/Init[2] 下,若用同一学习率
Proposition 2(高效微调):把两边学习率解耦,取
scaling the learning rates as
and ensures stability ( ) and efficiency of LoRA finetuning.
所以
推广到一般网络与 Adam:Theorem 1
论文随后把分析从线性玩具模型推广到任意深度的一般神经网络(第 4 节),并切换到实践中真正用的 Adam 型优化器。此时一个 LoRA 层的(处理后)梯度与更新写作
其中
Theorem 1 (Efficient LoRA, Informal):Assume that weight matrices
and are trained with Adam with respective learning rates and . Then, it is impossible to achieve efficiency with , but LoRA Finetuning is efficient with and .
即高效要求学习率比
LoRA+ : set the learning rates for
such that with fixed and tune .
LoRA+ 算法本体:一行优化器分组
整套方法落地只需把
# 把 A、B 拆成两个 param group,B 的 lr = lambda * base_lr
lambda_ratio = 16          # Init[2] / RoBERTa 上的稳健默认
base_lr = 1e-4

param_groups = []
for name, p in model.named_parameters():
    if not p.requires_grad:
        continue
    if "lora_B" in name:
        param_groups.append({"params": p, "lr": base_lr * lambda_ratio})
    else:  # lora_A、bias、norm 等其它可训练项归基准组
        param_groups.append({"params": p, "lr": base_lr})

optimizer = torch.optim.AdamW(param_groups)
与 Init[1] 下 peft 及部分训练框架已内置 LoRA+ 选项,可直接传 loraplus_lr_ratio。
怎么定
理论最优阶是
Init[2](随机、 零):RoBERTa 上 一般能提升性能(Figure 7 的设置)。 Init[1](原版,零):最优比偏小,约 。 - Llama 实验:最优比约
。 - 先按普通 LoRA 找一个可用基准
、再固定它去扫 ,比同时调两个参数高效;Figure 6 显示最优比在 top-4 配置里有显著方差,对 model/task 敏感。
实验结果:RoBERTa / GPT-2 / Llama 上 1–2% 提升、约 2× 加速
评测设置
- GLUE 任务:用 LoRA 微调 RoBERTa-base 与 GPT-2 于 MNLI / QQP / SST2 / QNLI;超参
、FP16、序列长 ,MNLI/QQP/QNLI 训 3 epoch、SST2 训 10 epoch,结果对 3 个随机种子取平均。在 网格上扫,红字标"全局最优"与" (标准做法)"两类结果。 - Llama-7b:在 flan-v2(10 万子集、1 epoch,
、适配每个线性层、评 MMLU)与 MNLI( 、1 epoch)上验证,每组 2 个种子取平均。
Benchmark 表现(以原文为准)
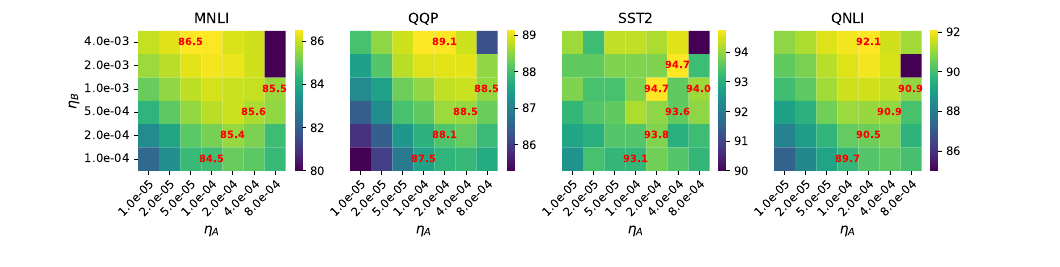
图源:Hayou, Ghosh & Yu, LoRA+: Efficient Low Rank Adaptation of Large Models(arXiv:2402.12354)Figure 3——RoBERTa-base GLUE 测试精度,最优学习率一致满足
(用于学习注解,版权归原作者)。
RoBERTa-base GLUE 最优精度 vs
| 任务 | LoRA+ 最优 | 提升 | |
|---|---|---|---|
| MNLI(难) | 84.5 | 86.5 | +2.0 |
| QQP(难) | 87.5 | 89.1 | +1.6 |
| SST2 | 93.1 | 94.7 | +1.6 |
| QNLI | 89.7 | 92.1 | +2.4 |
- 越"难"的任务收益越大:MNLI/QQP 上"全局最优"与"
"的差距比 SST2/QNLI 更明显——作者解释难任务更依赖高效特征学习。GPT-2(Figure 4,MNLI/QQP)结论一致:最优一律落在 。 - Llama-7b:flan-v2 上取
相对 在 MMLU 上约 +1.3%;而 MNLI 对 Llama 偏"易", 已接近最优、 不再显著加分——印证"易任务不太需要高效特征学习"。 - 约 2× 加速:下图是 RoBERTa-base 在 MNLI 上 LoRA+(
)对标准( , 经网格搜索)的测试精度曲线,LoRA+ 用约一半步数就达到标准做法收敛时的精度。
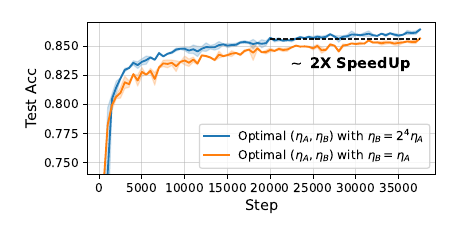
图源:Hayou, Ghosh & Yu, LoRA+: Efficient Low Rank Adaptation of Large Models(arXiv:2402.12354)Figure 7——LoRA+ vs 标准 LoRA,约 2× 收敛加速(用于学习注解,版权归原作者)。
看榜须知:以上数字口径(序列长
、epoch 数受限)与 Hu et al. 原 LoRA 论文( 、更多 epoch)不同,绝对值偏低;这里关键是同一设置下 与 的相对差,而非跨论文比绝对分。最优 仍 model/task 敏感,需小范围扫描。
在 LoRA 谱系里的位置:只动学习率分组,与结构/初始化/秩分配类变体正交可叠加
LoRA+ 与本章其它变体关注的"旋钮"互相正交,可对照阅读:
- vs LoRA(基线):LoRA+ 不动结构、不加参数,唯一改动是优化器的分组学习率(
),推理合并后与 LoRA 完全一致。主要卖点是更快收敛(约 1.5–2×)与小幅但稳定的最终提升(1–2%),在训练步数受限、或要快速跑通多配置时收益最明显。 - vs rsLoRA(缩放因子):rsLoRA 把缩放从
改成 、稳住大 rank 下的前向尺度;LoRA+ 调的是反向学习率。两者都改变"有效尺度",叠加时务必分开标定——先固定 rsLoRA 的 缩放,再单独调 LoRA+ 的 ,否则两个旋钮会互相掩盖。 - vs PiSSA(初始化):两者都想治 LoRA"初期学得慢",但路径不同——LoRA+ 从优化器学习率入手,PiSSA 从初始化(用主成分初始化
)入手。可视情况二选一或组合;尤其 LoRA+ 的 经验值本就随 Init[1]/Init[2]不同而变,换初始化方案时需重标定。 - vs AdaLoRA(秩分配):AdaLoRA 按重要性在层间动态分配 rank;LoRA+ 不碰 rank,只调学习率比,二者理论可叠加。
- vs DoRA(幅值-方向解耦)/ QLoRA(量化基座):DoRA 改的是参数化形式、QLoRA 改的是基座精度;LoRA+ 与它们都不冲突,因为它只动学习率分组,可与多数变体并用。整体定位见 LoRA 家族总览。