
ORPO(KAIST AI):把偏好优化并进 SFT 的单体、无 reference 对齐
📄 ORPO: Monolithic Preference Optimization without Reference Model
2024-03 · KAIST AI(EMNLP 2024)· 代码
一句话:在标准 SFT 的 NLL 损失上叠加一个基于 odds ratio 的弱偏好惩罚项,让模型在抬高 chosen 似然的同时温和压低 rejected——单阶段、单模型、无需 reference model,就把「学会回答」与「对齐偏好」一次做完。
📖 论文原文 Abstract(英文)
While recent preference alignment algorithms for language models have demonstrated promising results, supervised fine-tuning (SFT) remains imperative for achieving successful convergence. In this paper, we study the crucial role of SFT within the context of preference alignment, emphasizing that a minor penalty for the disfavored generation style is sufficient for preference-aligned SFT. Building on this foundation, we introduce a straightforward and innovative reference model-free monolithic odds ratio preference optimization algorithm, ORPO, eliminating the necessity for an additional preference alignment phase. We demonstrate, both empirically and theoretically, that the odds ratio is a sensible choice for contrasting favored and disfavored styles during SFT across the diverse sizes from 125M to 7B. Specifically, fine-tuning Phi-2 (2.7B), Llama-2 (7B), and Mistral (7B) with ORPO on the UltraFeedback alone surpasses the performance of state-of-the-art language models with more than 7B and 13B parameters: achieving up to 12.20% on AlpacaEval2.0, 66.19% on IFEval (instruction-level loose), and 7.32 in MT-Bench. We release code and model checkpoints for Mistral-ORPO-α (7B) and Mistral-ORPO-β (7B).
相关:DPO · IPO · KTO · CPO · SimPO · SFT 总览
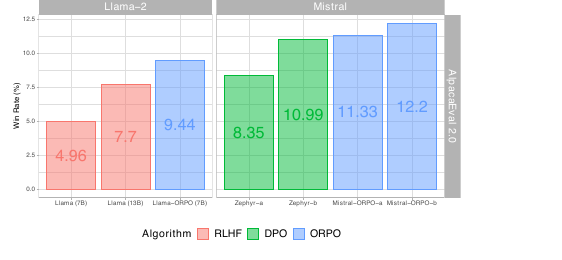
图源:Hong et al., ORPO: Monolithic Preference Optimization without Reference Model(arXiv:2403.07691)Figure 1——仅用单轮 UltraFeedback 训练,ORPO 模型即超过更大的 SOTA 指令模型(用于学习注解,版权归原作者)。
动机与创新点:SFT 会顺带抬高「坏回答」,给它配个温和惩罚就够
主流对齐流水线是 SFT → 偏好优化 的多阶段过程:先用 SFT 把预训练模型拉进目标域、学会任务格式,再用 DPO/RLHF 之类在偏好数据上对齐。论文指出这套流程存在两处可以合并的冗余。
第一,SFT 的交叉熵对「坏回答」没有任何抑制。 SFT 的目标是最大化目标回答的似然,但交叉熵损失只对 label token 有梯度——
其中
Both the log probability of chosen and rejected responses exhibited a simultaneous increase. … the absence of a penalty for unwanted generations results in rejected responses sometimes having even higher log probabilities than the chosen ones.
这正是后续要专门加一个偏好阶段来「纠偏」的根因之一。
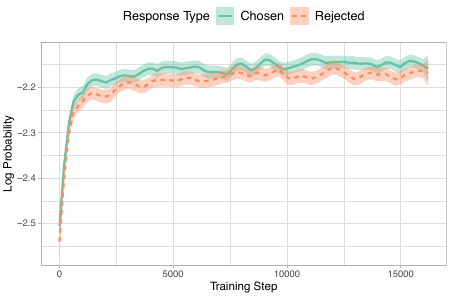
图源:Hong et al., ORPO(arXiv:2403.07691)Figure 3——SFT 缺少对 disfavored 风格的惩罚,rejected logprob 随训练同步上升(用于学习注解,版权归原作者)。
第二,多阶段意味着两份数据流程、两次训练,且 RLHF/DPO 还要一份 reference model。 RLHF 需要 SFT→reward model→PPO,DPO 需要 SFT 暖启 + 一个冻结的
ORPO 的解法:在标准 SFT 的 NLL 损失之外,加一个弱的 odds ratio 惩罚项("a minor penalty for the disfavored generation style is sufficient"),让模型抬高 chosen 似然的同时相对压低 rejected 的 odds。整个训练只有一个阶段、一个模型——这就是 "monolithic(单体)" 的含义。
关键创新:
- 单体损失 = SFT + odds ratio 惩罚:把偏好对比直接焊进 SFT 的交叉熵,一个前向同时算"学内容"和"分好坏"两件事。
- 无 reference model、无 SFT 暖启:可直接从预训练基座起训,每 batch 只需 2 次前向(DPO/RLHF 需 4 次),显存与算力都更省。
- 选 odds ratio 而非概率比:odds ratio 自带"软上限",对 rejected 的惩罚温和、不会过度压制 logits 导致退化——理论上比 DPO/IPO 用的概率比更适合与 SFT 共存。
- 小代价、强效果:仅用一轮 UltraFeedback,Phi-2/Llama-2/Mistral 经 ORPO 即超过参数量更大的 SFT+DPO、RLHF 模型。
方法:NLL + odds ratio 惩罚拼成的单体损失
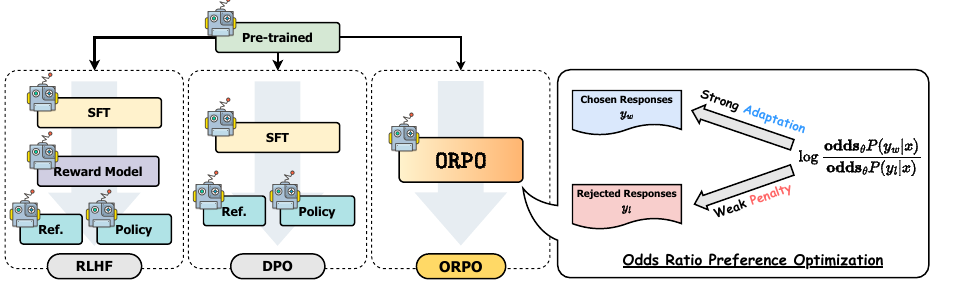
图源:Hong et al., ORPO(arXiv:2403.07691)Figure 2——ORPO 在单步内对 chosen 给强适配信号、对 rejected 给弱惩罚,把 log odds ratio 项接到 NLL 损失上,无需 reference model(用于学习注解,版权归原作者)。
预备:长度归一化的序列概率与 odds
给定输入
再定义生成
论文给的直觉是:"
举例:若模型对 chosen 给出
(odds )、对 rejected 给出 (odds ),则 ——模型生成好回答的"赔率"是坏回答的 4 倍,log odds ratio ,惩罚项会进一步把这个差拉大。
ORPO 目标函数:SFT 项 + odds ratio 项
ORPO 的损失由两部分相加:
是对 chosen 回答 的常规因果语言建模 NLL 损失,是主信号,保证模型持续学 chosen 的内容与格式、完成域适配; 是相对偏好项,用 log sigmoid 包住 log odds ratio:
最小化
为什么是 odds ratio 而非概率比:自带软上限,避免退化
DPO/IPO 这类先于 SFT 的方法用的是概率比:
论文论证:当偏好对齐被并进 SFT时,odds ratio 是更好的选择,因为"the probability ratio leads to more extreme discrimination of the disfavored responses than the odds ratio"。直观看,把
The excessive margin could lead to the unwarranted suppression of logits for tokens in disfavored responses within the incorporated setting, potentially resulting in issues of degeneration.
也就是说,概率比会过度压制 rejected 里 token 的 logits;在"模型尚未域适配(SFT 与对齐同时进行)"时,这种过猛抑制容易引发退化(degeneration)。odds ratio 的"mild discrimination of disfavored responses and the prioritizing of the favored responses"恰好与 SFT 项和平共处、不互相打架。这正是 IPO 诊断的 DPO 问题(确定性偏好下 log-likelihood ratio 无界放大)在 SFT-内嵌场景的体现。
举例:rejected 回答里有个 token 当前概率 0.3。概率比损失可能逼模型把它压到接近 0(连带破坏语言流畅度);odds ratio 损失因软上限只会温和下调,既区分了好坏、又不至于把模型"压坏"。
梯度视角:差得越多、惩罚越自动减弱
odds ratio 项的梯度可拆成两个因子
是惩罚项:当 chosen 的 odds 已远大于 rejected 时, ,"accelerating the parameter updates if the model is more likely to generate the rejected responses"——好坏分得越开,惩罚自动越弱;分不开时梯度才发力。这就是 odds ratio 自带"软上限"的来源。 是加权对比项:分母里的 会在对应回答似然偏低时放大梯度,对 chosen 而言"accelerates the model's adaptation toward the distribution of chosen responses as the likelihood increases"。
计算效率与实现要点(TRL ORPOTrainer)
因为不需要 reference model,ORPO 在两个层面更省:"1) memory allocation and 2) fewer FLOPs per batch"。RLHF/DPO 要为冻结的
ORPO 在 TRL 中由 ORPOTrainer 提供,一个 batch 的核心计算:
# logps_w, logps_l: 长度归一化的 (平均) logprob, 形状 [B]
# nll_loss:         对 chosen 回答 token 级交叉熵 (即 SFT 损失)

# log-odds = log p - log(1 - p) = logp - log(1 - exp(logp))
log_odds_w = logps_w - torch.log1p(-torch.exp(logps_w))
log_odds_l = logps_l - torch.log1p(-torch.exp(logps_l))
or_loss = -F.logsigmoid(log_odds_w - log_odds_l).mean()

loss = nll_loss + lam * or_loss
关键细节:
- 一次前向算两件事:chosen 的 NLL 直接复用其 logprob,无需第二个模型——这是 "monolithic" 的工程含义。
- 数值稳定:
在 logp 接近 0 时不稳定,需用 log1p/expm1等稳定写法(TRL 内部已处理)。 - 长度归一化概率用于 odds,避免长回答因 token 多而概率天然偏低。
调参与实践经验:
:常见 0.1~0.5 量级。太大,偏好惩罚盖过学习信号、可能损害基础能力;太小则几乎退化为纯 SFT,区分不出好坏。 - 可从基座直接训:把 SFT 和对齐合一,适合数据量适中、想省流程的场景;但若任务格式与基座差异很大,先做一轮轻量 SFT 再 ORPO 往往更稳。
- 学习率与 epoch:因为同时承担 SFT 职责,学习率可参考 SFT 设置;epoch 通常 1~3,过多易过拟合 chosen 风格。
实验结果:单阶段、无 ref,却超过更大的 SFT+DPO / RLHF 模型
评测设置
底座从 OPT 125M–1.3B(受控对比 SFT/PPO/DPO/ORPO)到 Phi-2 (2.7B)、Llama-2 (7B)、Mistral (7B);数据集为 HH-RLHF 与二值化 UltraFeedback(过滤掉
AlpacaEval 主结果(以原文为准)
| 模型 | 规模 | AlpacaEval 1.0 | AlpacaEval 2.0 |
|---|---|---|---|
| Phi-2 + SFT | 2.7B | 48.37 | 0.11 |
| Phi-2 + SFT + DPO | 2.7B | 50.63 | 0.78 |
| Phi-2 + ORPO | 2.7B | 71.80 | 6.35 |
| Llama-2 Chat * | 7B | 71.34 | 4.96 |
| Llama-2 Chat * | 13B | 81.09 | 7.70 |
| Llama-2 + ORPO | 7B | 81.26 | 9.44 |
| Zephyr-α * | 7B | 85.76 | 8.35 |
| Zephyr-β * | 7B | 90.60 | 10.99 |
| Mistral-ORPO-α | 7B | 87.92 | 11.33 |
| Mistral-ORPO-β | 7B | 91.41 | 12.20 |
(* 为官方榜单结果。)几条关键观察:
- 小模型 ORPO 超过 SFT+DPO:Phi-2 ORPO 把 AlpacaEval 1.0 从 48–50% 拉到 71.80%,且只用 UltraFeedback 就超过 Llama-2-Chat。
- 跨规模超过更大模型:Llama-2-7B + ORPO(81.26 / 9.44)超过 Llama-2-Chat 13B(81.09 / 7.70);Mistral-ORPO-α/β 超过用 SFT(20K UltraChat)+DPO 训的 Zephyr-α/β。
- MT-Bench:Mistral-ORPO-α/β 得 7.23 / 7.32,与更大或闭源模型(Llama-2-Chat 70B、Claude)相当——且训练未见过多轮对话数据。
- IFEval(instruction-level loose):两个 Mistral 模型分别 61.63% / 66.19%。
论文还做了一个对照实验:对 Llama-2 跑"1 epoch SFT + 3 epoch DPO",得到的模型输出甚至无法评测——印证了 ORPO"用有限数据快速学到域 + 偏好"的有效性。
胜率与奖励分布
用 RM-1.3B 在 HH-RLHF / UltraFeedback 上算胜率,ORPO 一致优于 SFT、PPO,对 DPO 的胜率随模型增大而升高(OPT-1.3B 对 DPO 达 70.9%)。
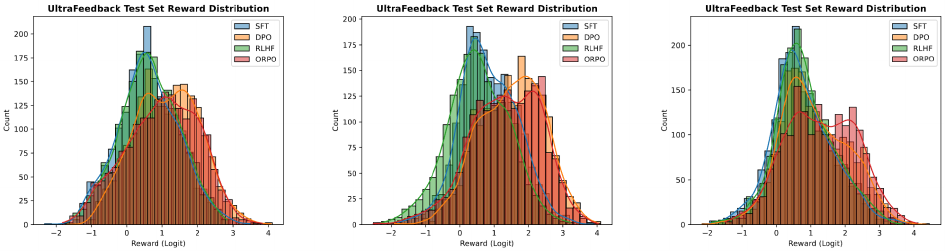
图源:Hong et al., ORPO(arXiv:2403.07691)Figure 5——三种规模下 ORPO 把奖励分布推到最右(期望奖励最高),优于或持平 RLHF/DPO(用于学习注解,版权归原作者)。
此外,词汇多样性分析(用 Gemini-Pro 嵌入算 per-input / across-input 余弦相似度)显示:ORPO 的 per-input 多样性低("assigns high probabilities to the desired tokens",对单条输入更确定),但 across-input 多样性高("triggers the model to generate more instruction-specific responses than DPO",跨输入更贴指令、更不雷同)。
看榜须知:这些分数的口径、时点、底座、
、test-time 设置各异,跨系统直接比绝对值意义有限,当作"同期同规模下单阶段对齐能力的量级参照"即可。
在偏好优化谱系里的位置
ORPO 与 SFT+DPO 流程的直接对照:
| 维度 | SFT + DPO | ORPO |
|---|---|---|
| 训练阶段 | 两阶段(先 SFT,再 DPO) | 单阶段 |
| Reference model | 需要(冻结 | 不需要 |
| 数据 | SFT 数据 + 偏好数据 | 偏好数据(chosen 兼作 SFT 目标) |
| 起点 | 通常需先有 SFT 模型 | 可直接从基座开始 |
| 每 batch 前向 | 4 次(ref/policy × chosen/rejected) | 2 次 |
| 对比信号 | 概率比(log-ratio,分布尖、易过压) | odds ratio(自带软上限) |
| 显存 / 计算 | 高(两轮 + ref) | 低(一轮,一个模型) |
- vs DPO:DPO 把 RLHF 的两阶段压成一阶段,但仍要 SFT 暖启 + reference model;ORPO 更进一步,把 SFT 与对齐也合并、彻底去掉 reference。代价是 chosen 必须本身质量足够当 SFT 目标。
- vs IPO:IPO 诊断出 DPO 的概率比在确定性偏好下无界放大、过拟合,改用有界平方损失;ORPO 从另一角度回应同一问题——换成 odds ratio 让对比"自带软上限",并把这一选择放进 SFT-内嵌的语境里论证(概率比在未域适配时会过度压制 rejected logits 致退化)。
- vs KTO:KTO 不需要成对偏好数据(用前景理论对单条 good/bad 打分),ORPO 仍依赖成对
,但同样走"无 reference 之外再省一个阶段"的简化路线。 - vs CPO / SimPO:三者都属"去 reference model"的偏好优化家族。CPO 同样把 SFT 项与无 ref 偏好项相加(用概率比近似);SimPO 用长度归一化的平均对数概率 + margin、彻底无 ref。ORPO 的独特点是用 odds ratio 作对比信号 + 显式从"SFT 会抬高 rejected"的动机出发,定位为"preference-aligned SFT"而非"去掉 SFT 的偏好优化"。
- 整体定位见 DPO 系方法总览。