
PPO(OpenAI):用裁剪代理目标做一阶信赖域的策略优化
📄 Proximal Policy Optimization Algorithms
2017-07 · OpenAI · 代码(OpenAI Baselines PPO2)
一句话:用一个「裁剪的重要性采样比值」把每步策略更新夹在旧策略附近,只靠一阶 SGD 就拿到 TRPO 的稳定性与数据效率;它后来成为 RLHF(InstructGPT 起)对齐大模型的默认策略优化算法。
📖 论文原文 Abstract(英文)
We propose a new family of policy gradient methods for reinforcement learning, which alternate between sampling data through interaction with the environment, and optimizing a "surrogate" objective function using stochastic gradient ascent. Whereas standard policy gradient methods perform one gradient update per data sample, we propose a novel objective function that enables multiple epochs of minibatch updates. The new methods, which we call proximal policy optimization (PPO), have some of the benefits of trust region policy optimization (TRPO), but they are much simpler to implement, more general, and have better sample complexity (empirically). Our experiments test PPO on a collection of benchmark tasks, including simulated robotic locomotion and Atari game playing, and we show that PPO outperforms other online policy gradient methods, and overall strikes a favorable balance between sample complexity, simplicity, and wall-time.
相关:RLHF 总览 · Reward Model · 训练循环机制 · GRPO · RLOO · REINFORCE++
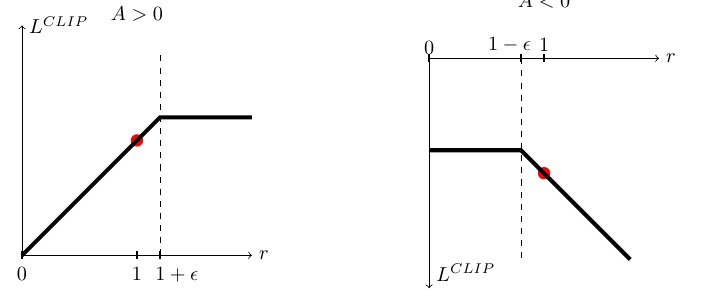
图源:Schulman et al., Proximal Policy Optimization Algorithms(arXiv:1707.06347)Figure 1——
单个时间步随概率比 的变化,正/负优势各裁一侧(用于学习注解,版权归原作者)。
动机与创新点:把「别走太远」塞进损失函数,一阶优化器即可实现信赖域
普通策略梯度(REINFORCE、vanilla PG)的核心问题是步长不可控:论文指出在同一批轨迹上多步优化
TRPO(Schulman et al., 2015)的解法是给代理目标外挂一个二阶 KL 信赖域硬约束——
——它稳定,但要算共轭梯度/Fisher 向量积,"is relatively complicated, and is not compatible with architectures that include noise (such as dropout) or parameter sharing"。PPO 的目标是 "to attain the data efficiency and reliable performance of TRPO, while using only first-order optimization":不解约束优化,而是把「别偏离旧策略太远」直接写进损失函数本身,让普通 Adam 就能跑,并且能在一批数据上安全地做多个 epoch 的 minibatch 更新(这是 sample efficiency 的来源)。
关键创新:
- 裁剪代理目标
:对概率比 做 裁剪,再与未裁剪项取 min,构成对真实目标的悲观下界(pessimistic / lower bound)——只在「改动会让目标变好」时才忽略它、在「会让目标变坏」时才计入它。 - 一阶 + 可多 epoch 复用:相比 TRPO 的二阶优化,PPO 只需对该目标做几轮 minibatch SGD,实现只比 vanilla PG 多几行代码,且兼容 dropout、参数共享、RNN。
- 自适应 KL 惩罚变体
:把 KL 当软惩罚加进目标、按目标 KL 自动调系数 ——作为对照基线(论文实测效果不如裁剪)。 - 与 GAE / actor-critic 无缝组合:value 共享网络时把策略代理、value 误差、熵奖励合成单一目标联合优化。
这套「一阶、稳、可多 epoch 复用」的组合让 PPO 成为后来 RLHF 的默认策略优化器——InstructGPT 用它把奖励模型分数回灌进语言模型,下文「方法」一节给出 token 级实例化。
方法:从连续控制原版到 RLHF token 级实例
裁剪代理目标
记概率比
其中
the final objective is a lower bound (i.e., a pessimistic bound) on the unclipped objective. With this scheme, we only ignore the change in probability ratio when it would make the objective improve, and we include it when it makes the objective worse.
对照开头的 Figure 1 看机制:
(这个动作好):增大其概率, 涨到 就封顶,再涨不贡献梯度——"好的别奖太多"; (这个动作坏):减小其概率, 跌到 就封底——"坏的别罚太狠"。
举例(RLHF):奖励模型给某条回答打了高分(
)。若不裁剪,模型会把这条回答里每个 token 的概率往死里拉高、迅速偏离参考策略变成复读机;裁剪让它「这一批最多把概率比抬到 1.2 倍」,逼模型多攒几批数据、小步慢走。
注意
自适应 KL 惩罚
PPO 还给了第二种实现——把 KL 当软惩罚而非裁剪:
固定
- 若
(走得太保守)→ ; - 若
(走得太猛)→ 。
论文明说 1.5 与 2 是启发式、算法对它们不敏感,初值
优势估计 GAE 与共享网络的联合目标
PPO 沿用截断版广义优势估计(GAE,Schulman et al., 2015):跑长度
当策略与 value 共享网络参数时,必须把 value 误差并进目标;再加熵奖励鼓励探索,得到论文实际优化的合成目标(eq. 9):
其中
完整算法:N 个 actor 并行采样 + K 个 epoch 复用
PPO 的主循环(论文 Algorithm 1,actor-critic 风格):
Each iteration, each of N (parallel) actors collect T timesteps of data. Then we construct the surrogate loss on these NT timesteps of data, and optimize it with minibatch SGD (or usually for better performance, Adam), for K epochs.
「一批数据做 K 个 epoch」正是 PPO 比 vanilla PG 省采样的关键——而裁剪正是让这种复用安全的前提(多 epoch 会让
RLHF token 级实例:把奖励模型分数回灌进语言模型
PPO 原版面向机器人/Atari;用于 RLHF 时把语言生成建成序列决策 MDP——状态
奖励构成:奖励模型
这就是上一节提到的「KL 进 reward」路线(per-token KL penalty):它影响优势估计(KL 项进入
Critic 损失:value head 回归到 GAE 目标
四个模型同时驻留:policy(训练)、critic(训练)、reference(冻结,算 KL)、reward model(冻结,打分)。这是 PPO 在 RLHF 里显存开销大、工程复杂的根源,也是后续 GRPO / RLOO 砍掉 critic 的动机所在。
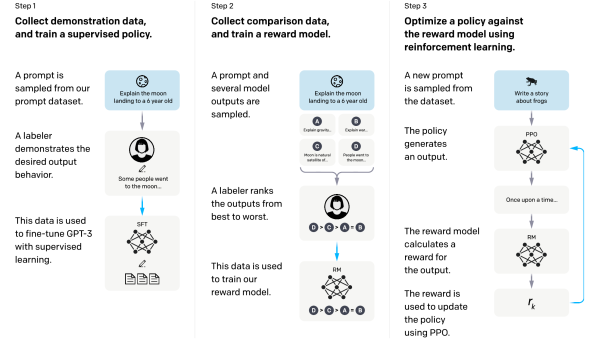
图源:Ouyang et al., Training language models to follow instructions with human feedback (InstructGPT)(arXiv:2203.02155)Figure 2——RLHF 三阶段,PPO 是第三阶段的策略优化器(用于学习注解,版权归原作者)。
工程实现与调参经验
# PPO-for-RLHF 主循环(伪代码)
for iteration in range(N):
    # 1) Rollout:用 π_old 采样回答,并缓存 logprob、value、reward
    prompts = sample_prompts(batch)
    responses, old_logprobs, values = policy.generate(prompts)      # π_old
    ref_logprobs = ref_model.logprobs(prompts, responses)          # 冻结
    rm_scores   = reward_model(prompts, responses)                 # 冻结,末端分
    rewards = per_token_kl_penalty(old_logprobs, ref_logprobs, beta)
    rewards[:, -1] += rm_scores                                    # 末端加 RM 分
    # 2) 计算优势与回报
    adv, returns = gae(rewards, values, gamma, lam)
    adv = whiten(adv)                                              # advantage 归一化
    # 3) 在同一批数据上做多个 epoch 的 minibatch 更新
    for epoch in range(ppo_epochs):          # 通常 1~4(RLHF),原论文 K=10
        for mb in minibatches(...):
            ratio = exp(policy.logprobs(mb) - mb.old_logprobs)
            pg_loss = -min(ratio*mb.adv, clip(ratio,1-eps,1+eps)*mb.adv)
            v_loss  = value_clip_loss(critic(mb), mb.returns, mb.values)
            loss = pg_loss.mean() + c_v*v_loss - c_ent*entropy
            loss.backward(); optimizer.step()
关键工程与调参细节:
- clip
:常用 (论文消融里 也最优,见下表);偏大更激进、偏小更保守。 、 :语言任务奖励集中在末端, 常取 (不折扣), 取 左右。 - KL 系数
:RLHF 里最关键的稳定旋钮。太小则 reward hacking、模型跑飞;太大则学不动、退化回 SFT。常配合 adaptive KL(目标 KL 高于设定就增大 ,反之减小)。 - 重放 epoch 数:同批数据更新 1~4 个 epoch(RLHF 实践,比原论文 K=10 保守);越多越省采样但越易让
偏离 ,clip 触发频繁。 - 归一化:advantage whitening(减均值除标准差)几乎是必做;reward scaling/clipping 也常见。
- 崩溃征兆:① KL 爆炸——
急速偏离 、输出乱码或重复,立即加大 或降学习率;② 熵塌缩——策略熵骤降、输出高度雷同、探索消失,多因学习率过大或 reward 过尖;③ reward 与 KL 同时飙升——典型 reward hacking,RM 被钻空子,需回看 RM 质量。 - critic 预热:开训前先让 critic 单独拟合几步 value,可减少早期优势估计噪声。
- 采样规模:rollout batch 越大优势估计越稳,但生成是瓶颈,通常用 vLLM 等推理引擎加速采样阶段。
实验结果:代理目标消融 + MuJoCo/Atari 全面占优(以原文为准)
代理目标消融:裁剪
论文先在 7 个 MuJoCo 连续控制任务上比较各代理目标变体(各跑 100 万步、3 个种子,分数归一化到「随机策略=0,最佳=1」后对 21 次运行取平均):
| 代理目标 | 平均归一化分 |
|---|---|
| 无裁剪无惩罚(vanilla | −0.39 |
| 裁剪 | 0.76 |
| 裁剪 | 0.82 |
| 裁剪 | 0.70 |
| 自适应 KL | 0.68 |
| 自适应 KL | 0.74 |
| 自适应 KL | 0.71 |
| 固定 KL | 0.62 / 0.71 / 0.72 / 0.69 |
无裁剪无惩罚直接跑崩(half-cheetah 上比随机策略还差,拖成负分),验证了「步长不控会炸」;裁剪整体优于 KL 惩罚,
连续控制与 Atari 对比
在 MuJoCo 上把 PPO(裁剪、
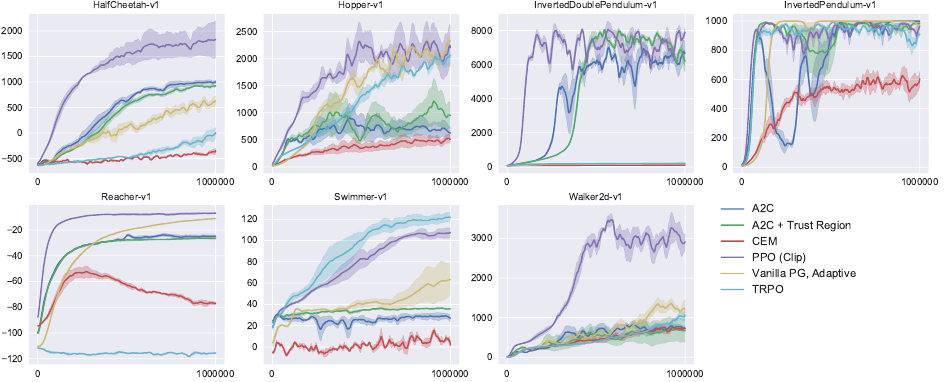
图源:Schulman et al., Proximal Policy Optimization Algorithms(arXiv:1707.06347)Figure 3——MuJoCo 连续控制基准上 PPO 与多种基线的对比(用于学习注解,版权归原作者)。
在 Atari(49 游戏) 上与调好的 A2C、ACER 比,按两种口径数「赢了几个游戏」(3 次取均值):
| 评分口径 | A2C | ACER | PPO | 平 |
|---|---|---|---|---|
| 全程平均 episode reward(favors 快学习) | 1 | 18 | 30 | 0 |
| 末 100 episode 平均(favors 终性能) | 1 | 28 | 19 | 1 |
PPO 在「学得快」一档拿下 30/49 第一;ACER 在「最终性能」一档以 28 反超,但 PPO 实现简单得多(论文结论原话:与 A2C 简洁度相当、却显著更稳)。作者还用 Roboschool 3D 人形机器人展示了 PPO 在高维连续控制(跑动、转向、被砸后爬起)上的可扩展性。
看榜须知:这些是 2017 年连续控制/Atari 的口径,与今天 RLHF 场景不可直接比;PPO 之于 RLHF 的「成绩」体现在 InstructGPT/ChatGPT 等下游对齐效果,而非本表数字。跨设置比绝对值意义有限。
在 RLHF / 策略优化谱系里的位置
PPO 是 RLHF 策略优化的事实基线,后续工作几乎都以「砍 critic / 改优势 / 改裁剪粒度」相对它定位:
| 维度 | PPO | GRPO / RLOO |
|---|---|---|
| Critic | 需要(再训一个同规模 value 网络) | 不需要 |
| 同时驻留模型 | 4(policy / ref / RM / critic) | 3 |
| 优势估计 | GAE,token 级、有 value 基线 | 组内相对,序列级 |
| 每 prompt 采样数 | 1(可多,但非必需) | |
| 显存与工程复杂度 | 高 | 中 |
| 稳定性 | 成熟可控,但调参敏感(KL/clip) | 实现简单,长序列下需额外修正 |
- vs TRPO:同样要「信赖域」,但 PPO 用一阶裁剪近似 TRPO 的二阶 KL 约束——牺牲一点理论严格性,换来实现简单、兼容 dropout/参数共享/RNN,这是它能在大模型上铺开的根本原因。
- vs GRPO / RLOO:两者共同动机是干掉 critic——PPO 第二个「同规模训练网络」是显存与不稳定的大头。GRPO 用同一 prompt 的一组采样的组内相对奖励当优势基线,RLOO 用留一法基线,都把 4 模型压到 3 模型。代价是优势变成序列级、噪声更大,长序列下要额外修正。
- vs DAPO / GSPO:在 PPO/GRPO 的裁剪框架上继续打补丁——DAPO 提出非对称裁剪(clip-higher)、动态采样等一组「让裁剪在长 CoT RL 下更稳」的工程改良;GSPO 把重要性比值从 token 级抬到序列级,缓解 token 级比值在超长序列上的方差与裁剪失配。
- vs REINFORCE++:另一条「轻量化」路线——保留 PPO 的若干稳定技巧(KL 归一化、reward clip 等)但回归更简单的 REINFORCE 式更新,介于 vanilla PG 与完整 PPO 之间。
- 整体训练循环(rollout → 打分 → 优势 → 更新)与各算法的位置见 训练循环机制 与 RLHF 总览。