
AdaLoRA(微软 & 佐治亚理工):按重要性给每个模块自适应分配秩预算
📄 AdaLoRA: Adaptive Budget Allocation for Parameter-Efficient Fine-Tuning
2023-03 · Georgia Tech & Princeton & Microsoft Azure AI(ICLR 2023) · 代码
一句话:标准 LoRA 给每个被注入的模块发同样大小的秩,AdaLoRA 把增量改写成 SVD 形式
📖 论文原文 Abstract(英文)
Fine-tuning large pre-trained language models on downstream tasks has become an important paradigm in NLP. However, common practice fine-tunes all of the parameters in a pre-trained model, which becomes prohibitive when a large number of downstream tasks are present. Therefore, many fine-tuning methods are proposed to learn incremental updates of pre-trained weights in a parameter efficient way, e.g., low-rank increments. These methods often evenly distribute the budget of incremental updates across all pre-trained weight matrices, and overlook the varying importance of different weight parameters. As a consequence, the fine-tuning performance is suboptimal. To bridge this gap, we propose AdaLoRA, which adaptively allocates the parameter budget among weight matrices according to their importance score. In particular, AdaLoRA parameterizes the incremental updates in the form of singular value decomposition. Such a novel approach allows us to effectively prune the singular values of unimportant updates, which is essentially to reduce their parameter budget but circumvent intensive exact SVD computations. We conduct extensive experiments with several pre-trained models on natural language processing, question answering, and natural language generation to validate the effectiveness of AdaLoRA. Results demonstrate that AdaLoRA manifests notable improvement over baselines, especially in the low budget settings. Our code is publicly available at https://github.com/QingruZhang/AdaLoRA.
相关:LoRA(前置) · QLoRA · rsLoRA · LoRA+ · PiSSA · DoRA
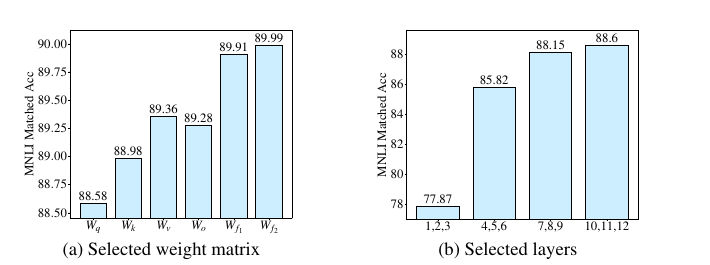
图源:Zhang et al., AdaLoRA: Adaptive Budget Allocation for Parameter-Efficient Fine-Tuning(arXiv:2303.10512)Figure 1——同等参数预算下,FFN 层与高层比注意力层、底层更"吃"容量(用于学习注解,版权归原作者)。
动机与创新点:秩不该平均分——把"分配预算"做成可微、可调度的剪枝
标准 LoRA 在所有被注入的模块上使用同一个固定的秩
"the importance of weight matrices varies significantly across modules and layers when fine-tuning pre-trained models."
给所有模块发同样的额度,等价于一部分模块严重过剩、另一部分却被饿着。一个朴素的补救是"先用大
AdaLoRA 的破题方式是:不去算 SVD,而是把增量直接参数化成 SVD 的形状
"How can we allocate the parameter budget adaptively according to importance of modules to improve the performance of parameter-efficient fine-tuning?"
关键创新:
- SVD 形式参数化:把
换成 ( 为对角奇异值),剪枝时只需把奇异值置零、保留奇异向量,既避开昂贵的精确 SVD,又给"误剪后恢复"留了余地。 - 奇异方向 = 可独立增删的最小单元:每个"秩-1 三元组"
是预算分配的原子,正交正则保证奇异值的"重要性"含义不失真。 - 基于敏感度的重要性打分:不以奇异值大小论英雄,而用"参数 × 梯度"的敏感度(损失对该参数置零的一阶泰勒估计),再做指数滑动平均 + 不确定性平滑,得到稳健的三元组重要性。
- 全局预算调度器:训练分"预热 → 三次衰减 → 固定"三段,总预算从略高的初值平滑降到目标值,每隔若干步把全局得分最低的三元组奇异值置零。
- 效果集中在低预算区:参数预算越紧,AdaLoRA 相对固定秩 LoRA 的优势越明显(指标见「实验结果」)。
方法:SVD 参数化 + 重要性感知的秩分配 + 全局预算调度
AdaLoRA 由两块拼成:(i) SVD-based adaptation——把增量写成 SVD 形状;(ii) importance-aware rank allocation——按新设计的重要性指标迭代剪掉冗余奇异值。下面逐块拆开。
SVD 形式参数化:把增量写成
每个模块的增量被参数化为类 SVD 的三元组:
其中
为了让
为什么不直接对
"First, when a doublet is measured as unimportant, we have to prune all of its elements. It makes scarcely possible to reactivate the pruned doublets as their entries are all zeroed out and not trained. ... Second,
and of LoRA are not orthogonal, meaning the doublets can be dependent with each other. Discarding the doublets can incur larger variation from the original matrix than truncating the smallest singular values."
也就是说:(1) doublet 一旦清零就再难复活;(2)
举例:把
想成一束"方向 + 强度"。LoRA 的成对剪枝是连方向带强度一起拔掉,拔错了方向也没了;AdaLoRA 只是把某个方向的强度调到 0,方向( 的对应列/行)还在原地,下次它重要起来,强度可以再涨回去。
重要性感知的秩分配:用"参数 × 梯度"的敏感度打分
剪哪些三元组?AdaLoRA 不直接用奇异值
论文解释 "(8) essentially approximates the change in loss when a parameter is zeroed out"——这正是把该参数置零后损失变化的一阶泰勒估计:移除它影响越大,说明模型对它越敏感、越该留。一个三元组的整体重要性把奇异值、
单步敏感度噪声太大,再加两道平滑。 论文沿用 Zhang et al. (2022) 的观察——单 mini-batch 上估的
最终单元打分取两者之积
全局预算调度:先宽后窄的三次衰减
把"秩"当成预算来调:定义第
总预算随时间走"先宽后窄"的三段课程:
- 预热(
):固定在略高的初始预算 (论文取目标 的约 1.5 倍),让所有三元组先学一会儿、把空间探索开,避免过早误杀; - 三次衰减(
):按 cubic schedule 把总预算从 平滑降到目标 ,每隔 步(如 100 步)剪一次、把全局重要性最低的若干奇异值置零; - 固定(末段
步):锁定目标预算分布,继续训练到收敛。
"先探索、后聚焦"——This allows AdaLoRA to explore the parameter space first and then focus on the most important weights later. 训练目标是任务损失加正交正则
下图是 AdaLoRA 在 MNLI 上微调 DeBERTaV3-base 后,各增量矩阵学到的秩分布——和动机实验完全吻合:预算自动涌向 FFN(
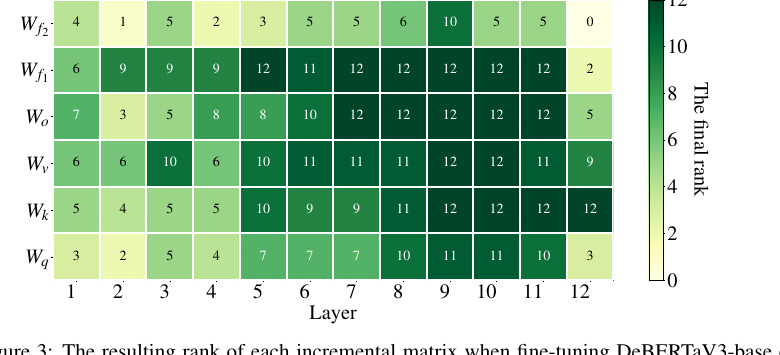
图源:Zhang et al., AdaLoRA: Adaptive Budget Allocation for Parameter-Efficient Fine-Tuning(arXiv:2303.10512)Figure 3——更多预算被自适应分配给 FFN 与高层,验证了重要性打分能引导预算聚焦关键模块(用于学习注解,版权归原作者)。
整体流程与实现要点
# 训练步内的伪代码(每个 AdaLoRA 模块)
h = x @ W0.T + (x @ Q.T) @ Lambda @ P.T          # 前向:x P Λ Q
loss = task_loss(h, target) + gamma * ortho_reg(P, Q)   # 正交正则只对 P、Q
loss.backward()

# 敏感度 = |参数 * 梯度|,再做 EMA 平滑 + 不确定性平滑
for w in (P_col_i, Lambda_ii, Q_row_i):
    I_bar = beta1 * I_bar + (1 - beta1) * (w.detach() * w.grad).abs()
    U_bar = beta2 * U_bar + (1 - beta2) * (I_inst - I_bar).abs()
score_i = aggregate(I_bar * U_bar over the i-th triplet)   # 见公式 (7)

# 每 Δ_T 步剪一次:按 cubic schedule 算当前总预算 b(t),保留得分最高的三元组
budget = cubic_schedule(t, b0, bT, warmup, final)
mask = topk_by_score(scores, k=budget)           # 选出保留的三元组
Lambda.data[~mask] = 0.0                          # 奇异值置零 = 剪枝;P/Q 不动
实现层面注意:①正交正则只对
实验结果:低预算区优势最明显
底座/数据:DeBERTaV3-base(GLUE 自然语言理解、SQuADv1.1/v2.0 问答)与 BART-large(XSum、CNN/DailyMail 摘要生成)。对手是同等可训练参数预算下的 Full FT、BitFit、Houlsby/Pfeiffer Adapter,以及加在全部权重矩阵上的 generalized LoRA(
GLUE / SQuAD(DeBERTaV3-base)
| 任务 | 预算 | 最优 baseline | LoRA | AdaLoRA |
|---|---|---|---|---|
| MNLI (m/mm) | 1.27M | 90.33/90.39 | 90.65/90.69 | 90.76/90.79 |
| CoLA (Mcc) | 0.32M | 69.48 | 68.71 | 70.04 |
| RTE (Acc) | 0.32M | 85.56 | 85.56 | 87.36 |
| SQuADv2.0 (EM/F1) | 0.08% | 84.7/87.5 | 84.7/87.5 | 85.6/88.7 |
| SQuADv2.0 (EM/F1) | 0.65% | — | 85.0/88.0 | 86.0/88.9 |
- 极低预算下差距最大:CoLA 在 0.3M 参数下 AdaLoRA 70.04,高于所有 baseline 用更高预算(0.6M、1.2M)的结果;RTE 在 0.3M 下 87.36,比最强 baseline 高 1.8%。
- SQuADv2.0 在仅 0.08% 可训练参数下达 88.7 F1,比最优 baseline 高 1.2% F1,且接近自己在 4.65% 高预算下的表现。
不同预算下 AdaLoRA vs LoRA(Figure 2)
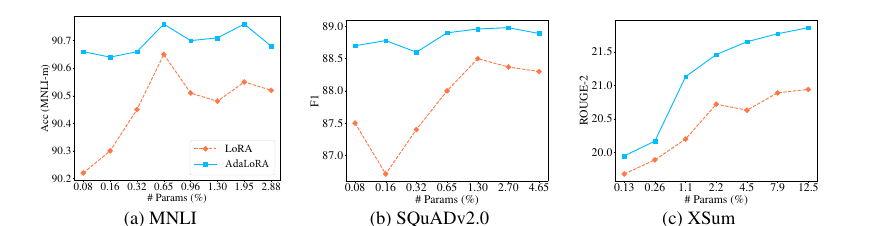
图源:Zhang et al., AdaLoRA: Adaptive Budget Allocation for Parameter-Efficient Fine-Tuning(arXiv:2303.10512)Figure 2——三个任务、各档预算下 AdaLoRA 一致优于 LoRA,低预算区增益尤其显著(用于学习注解,版权归原作者)。
论文据此总结:在 MNLI/SQuADv2.0 上,AdaLoRA 用
关键消融
- vs 对 LoRA 做成对剪枝(SST-2/RTE/CoLA,Table 4):AdaLoRA 在所有数据集、所有预算上都胜出——印证"剪奇异值(保留奇异向量、可恢复)优于剪 doublet(清零不可逆、训练不稳)"。
- 两个组件都重要(Table 5):只用 SVD 参数化(SVD-LoRA)已胜过 LoRA,但不如完整 AdaLoRA;去掉正交正则(
)会让性能退化——说明 SVD 参数化与自适应预算分配缺一不可。
看榜须知:以上数字均"以原文为准",且 baseline 口径、预算换算、底座规模、test-time 设置各不相同;不同表的"预算"既有按绝对参数量(M)也有按占比(%)计的。跨设置直接比绝对值意义有限,宜当作"同预算下相对固定秩 LoRA 的增益方向"来读。
在 LoRA 谱系里的位置
AdaLoRA 解决的是 LoRA 家族里一个很具体的子问题——"秩到底该怎么在模块间分配",与其他变体关注点基本正交,可对照阅读:
| 维度 | LoRA | AdaLoRA |
|---|---|---|
| 增量参数化 | ||
| 秩分配 | 全局固定 | 按模块/层自适应,训练中动态裁剪 |
| 重要性度量 | 无 | 敏感度(参数×梯度)+ 滑动平均 + 不确定性 |
| 额外正则 | 无 | 正交正则 |
| 训练复杂度 | 低 | 较高(打分、调度、正交正则) |
| 同预算下效果 | 基线 | 论文报告更优,低预算时差距最明显 |
| 推理 | 可合并,零开销 | 同样可合并为 |
- vs rsLoRA / LoRA+:AdaLoRA 管"秩怎么分",rsLoRA 管"缩放因子怎么随秩稳定",LoRA+ 管"
学习率怎么配",三者关注点正交、理论上可叠加,但叠加后调参空间显著变大、需谨慎。 - vs PiSSA / DoRA:PiSSA 也用 SVD,但用途相反——它拿预训练权重自身的主奇异成分来初始化 LoRA(一次性、静态),AdaLoRA 则是把增量写成 SVD 形并在训练中动态剪枝;DoRA 拆"幅度 + 方向"另辟蹊径。
- 何时值得用:当总参数预算被严格卡死(极端显存受限、或要把 adapter 压到很小)时,AdaLoRA 比固定秩 LoRA 更划算——论文的优势也正集中在低预算区。若预算不紧,工程上往往直接把 LoRA 的
调大就能逼近,从而省去打分、调度、正交正则的全部复杂度——这也是 AdaLoRA 在实际工程中使用度不如 LoRA/QLoRA 的主要原因。 - 训练成本:因为多了正交正则的
、 矩阵乘和逐三元组打分,单步开销比 LoRA 高,但相对全量微调仍然很小;推理阶段把 合并回 后与 LoRA 一样零额外开销。